„Gefunden, zurzeit nicht indexiert“ heißt: Google kennt die Adresse deiner Seite, hat die Seite aber noch nicht abgerufen. Auf einer kleinen Website liegt das selten an der Serverlast. Entweder ist die Seite neu und noch nicht an der Reihe, oder Google hält sie nicht für wichtig genug. In beiden Fällen bringt es nichts, die Seite immer wieder einzureichen. Finde zuerst die Ursache, behebe sie und beantrage danach einmal die Indexierung.
Ich habe den Status gerade auf zwei eigenen Websites. Auf 1powerstation.de, meiner Vergleichsseite für Powerstations und einem meiner SEO-Testprojekte, stehen am 17. November 2026 fünf Seiten auf „Gefunden, zurzeit nicht indexiert“ und 137 auf „Gecrawlt, zurzeit nicht indexiert“. Auf danielbeuing.de ist eine neue Rechnerseite innerhalb von vier Tagen von „URL ist Google nicht bekannt“ auf „Gefunden“ gewechselt. Bei Kunden fällt mir der Status im Audit auf. Bemerkt hatten sie ihn vorher nicht.
Wirtschaftlich ist die Rechnung einfach: Eine Seite, die nicht im Index steht, bringt über die Google-Suche keine einzige Anfrage. Ob das eine Seite trifft, auf die es ankommt, zeigt dir die Search Console.
In diesem Artikel zeige ich dir, was der Status bedeutet, wo du den Stand deiner Seiten siehst, wann Abwarten reicht und wann die Seite selbst das Problem ist. Dazu kommt, wann ein Antrag auf Indexierung hilft und wie ich das jede Woche prüfe.
Zusammenfassung
- „Gefunden, zurzeit nicht indexiert“: Google kennt die URL, hat die Seite aber noch nicht gecrawlt. Ein Datum des letzten Crawls gibt es deshalb nicht.
- Bei „Gecrawlt, zurzeit nicht indexiert“ hat Google die Seite gelesen und nicht in den Index aufgenommen.
- Googles Hilfe begründet „Gefunden“ mit drohender Überlastung der Website. Der Crawl-Budget-Leitfaden richtet sich an Websites ab rund 10.000 Seiten.
- John Mueller von Google sieht in dem Status meist ein Zeichen, dass Google von der Website nicht überzeugt ist (laut Search Engine Roundtable).
- Erst Technik, interne Links und Inhalt prüfen, dann einmal die Indexierung beantragen. Mehrere Anträge beschleunigen das Crawling laut Google nicht.
- Eine feste Wartezeit gibt es nicht: nach etwa einer Woche technisch prüfen, danach wöchentlich und später monatlich beobachten.
Inhaltsverzeichnis
- Was der Status in der Search Console bedeutet
- Wo du den Stand deiner Seiten siehst
- Wann Abwarten reicht
- Wann die Seite selbst das Problem ist
- Google-Indexierung beantragen: wann es hilft und wann nicht
- Gegenposition: Warteschlange oder Qualitätsurteil?
- So prüfe ich das jede Woche
- Was du selbst prüfen kannst
- Häufige Fragen
- Fazit
Was der Status in der Search Console bedeutet
Google hat die Adresse deiner Seite gefunden, die Seite selbst aber noch nicht abgerufen. So steht es in der Search-Console-Hilfe zum Bericht über die Seitenindexierung. Gefunden hat Google die Adresse über einen Link oder über deine Sitemap. Den Inhalt kennt Google noch nicht, und ohne Abruf kann Google nicht entscheiden, ob die Seite in den Index gehört.
Zwei Begriffe dazu: Crawlen heißt, der Googlebot ruft die Seite ab und liest sie. Indexieren heißt, Google nimmt die Seite in die Datenbank auf, aus der die Suchergebnisse kommen.
Als Grund nennt Google eine drohende Überlastung. Google habe die URL crawlen wollen, das hätte die Website aber überlastet. „Daher hat Google das Crawling neu geplant.“ Deshalb bleibt im Bericht das Feld mit dem Datum des letzten Crawls leer. Ob dieser Grund auf eine kleine Website passt, ordne ich weiter unten in der Gegenposition ein.
Fünf Stufen von „unbekannt“ bis „sichtbar“
Jeder Status in der Search Console beschreibt eine Stufe auf dem Weg in die Suchergebnisse. Eine Seite kann auf jeder Stufe hängen bleiben.
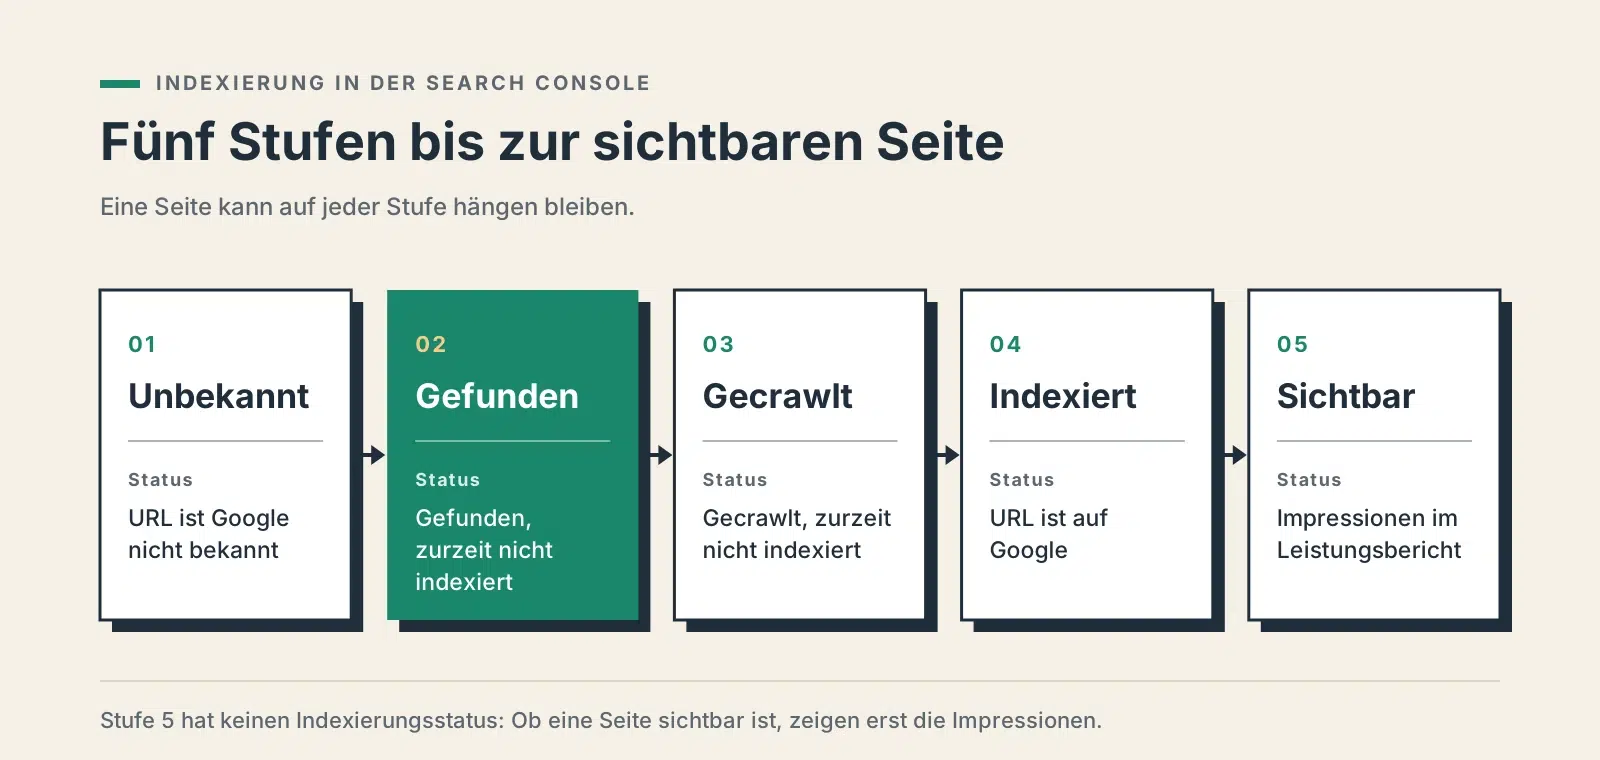
- URL ist Google nicht bekannt: Google hat die Adresse noch nicht gesehen.
- Gefunden, zurzeit nicht indexiert: Die Adresse ist bekannt, die Seite ist nicht abgerufen.
- Gecrawlt, zurzeit nicht indexiert: Die Seite ist abgerufen, aber nicht in den Index aufgenommen.
- Indexiert: Die Seite steht im Index und kann in den Suchergebnissen erscheinen.
- Sichtbar: Die Seite bekommt Impressionen für Suchanfragen. Für diese Stufe gibt es keinen Indexierungsstatus, du liest sie im Leistungsbericht ab.
Abgrenzung zu „Gecrawlt, zurzeit nicht indexiert“
Bei „Gecrawlt“ ist Google einen Schritt weiter: Die Seite wurde abgerufen und gelesen, und Google hat sie trotzdem nicht in den Index aufgenommen. Google schreibt dazu, dass nicht alle Seiten im Web indexiert werden und die Meldung nicht unbedingt auf ein Problem hinweist, das behoben werden muss. Für wichtige Seiten empfiehlt Google in derselben Hilfe, mit dem URL-Prüftool nach Problemen zu suchen.
Der Unterschied für dich: Bei „Gefunden“ hat Google über den Inhalt noch nichts erfahren. Bei „Gecrawlt“ kennt Google den Inhalt und hat sich gegen die Aufnahme entschieden. Auf 1powerstation.de betrifft das 137 Seiten. Was dort nach dem Core Update im November passiert ist, beschreibe ich im Artikel über meine Testseiten nach dem Core Update.
„URL ist Google nicht bekannt“: die Stufe davor
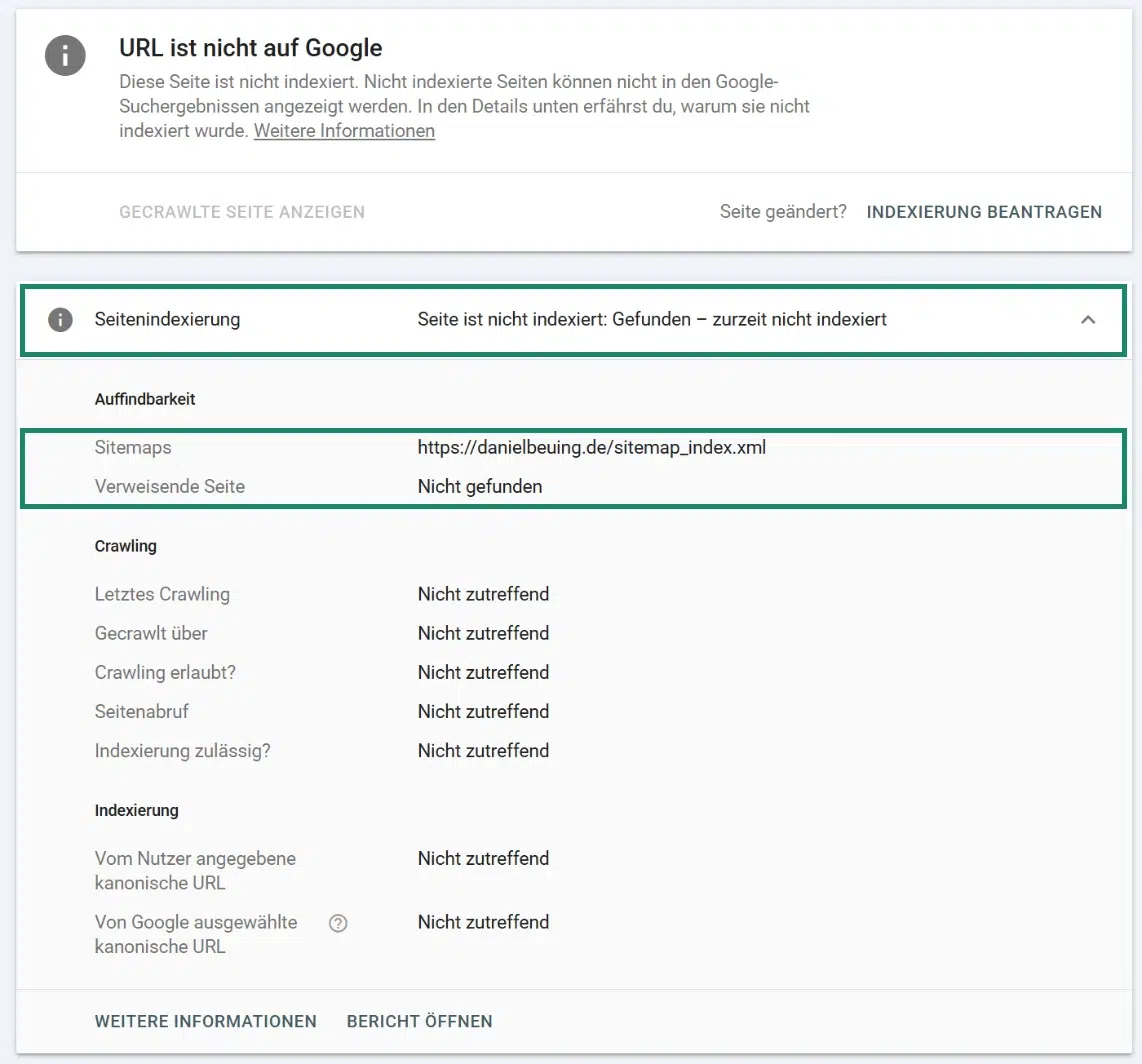
Mit diesem Status hat Google eine URL laut Hilfe zum URL-Prüftool noch nicht gecrawlt. So stand es am 13. November 2026 für meinen Customer-Lifetime-Value-Rechner. Am 17. November zeigte die URL-Prüfung „Gefunden, zurzeit nicht indexiert“. Als Sitemap nannte sie meinen Sitemap-Index, beim letzten Crawling stand „Nicht zutreffend“. Die Seite ist also eine Stufe weiter, gelesen hat Google sie noch nicht.
Wo du den Stand deiner Seiten siehst
Der Bericht zur Seitenindexierung zeigt dir, welche Seiten betroffen sind. Die URL-Prüfung zeigt dir den Stand einer einzelnen Seite. Du brauchst beide, weil sie nicht immer denselben Stand haben.
Der Bericht zur Seitenindexierung
Im Bericht stehen die Gründe, warum Seiten nicht indexiert sind, jeweils mit Anzahl, Quelle und Stand der Validierung. Die Spalte Quelle sagt, ob der Grund bei deiner Website liegt oder bei Google. Laut Google kannst du im Allgemeinen nur Probleme beheben, bei denen die Website als Quelle steht. „Gefunden“ und „Gecrawlt“ führt der Bericht unter Google-Systeme. Das heißt nur, dass Google keinen Fehler auf deiner Seite benennt. Die Ursache musst du selbst suchen.
So sah der Bericht von 1powerstation.de am 17. November 2026 aus: 53 Seiten indexiert, 5 Seiten „Gefunden, zurzeit nicht indexiert“, 137 Seiten „Gecrawlt, zurzeit nicht indexiert“.
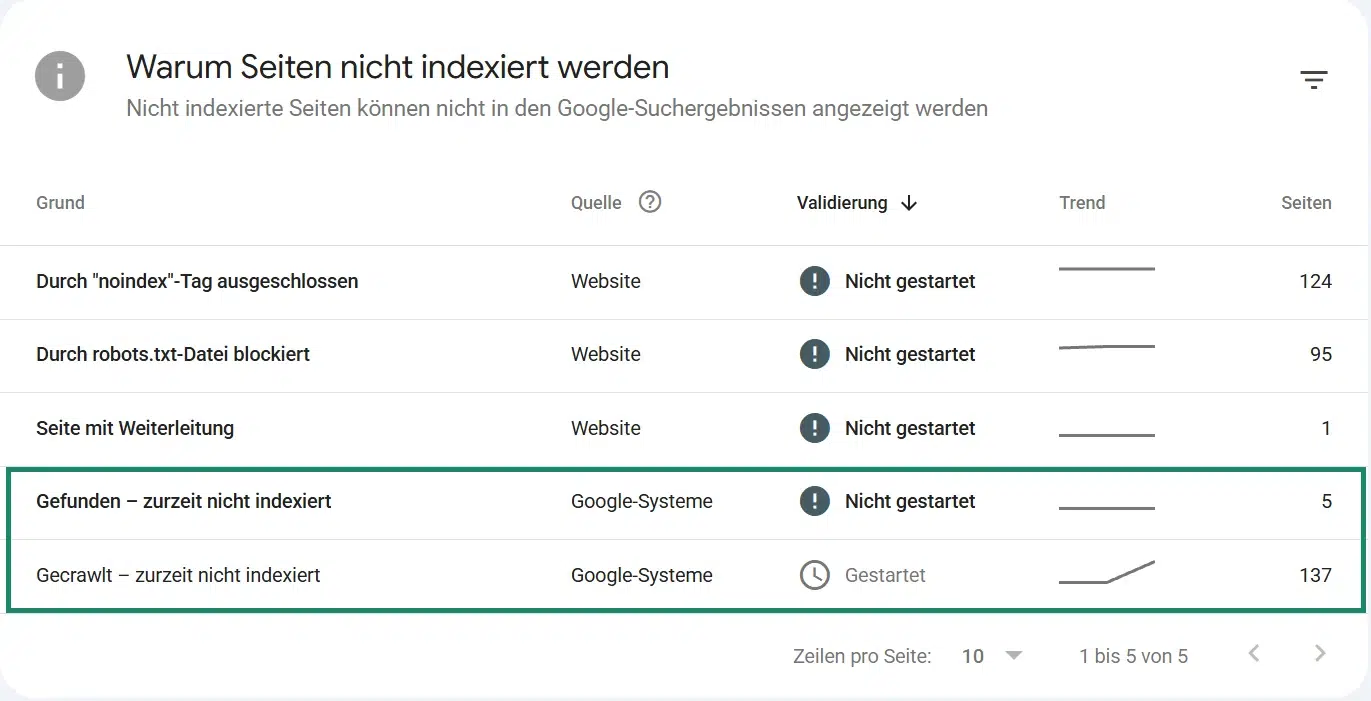
Die fünf Gefunden-Seiten sind die Bestenliste und vier Modellseiten. Laut Sitemap wurden die vier Modellseiten zwischen dem 30. Oktober und dem 5. November 2026 zuletzt geändert. Für die Bestenliste gibt die Sitemap kein Datum an. Beim letzten Crawling steht bei allen fünf „Nicht zutreffend“.
Für die 137 Gecrawlt-Seiten läuft eine Validierung. Mit der Schaltfläche „Fehlerbehebung überprüfen“ bittest du Google, die betroffenen URLs erneut zu prüfen. Das dauert laut Google in der Regel etwa zwei Wochen, manchmal deutlich länger.
Auf danielbeuing.de sieht der Bericht ruhiger aus. Unter „Gefunden“ steht genau eine URL, und das ist eine KML-Datei, die das Plugin Yoast Local SEO erzeugt, keine Inhaltsseite. Dazu kommen 14 URLs unter „Gecrawlt“ bei 65 indexierten Seiten.
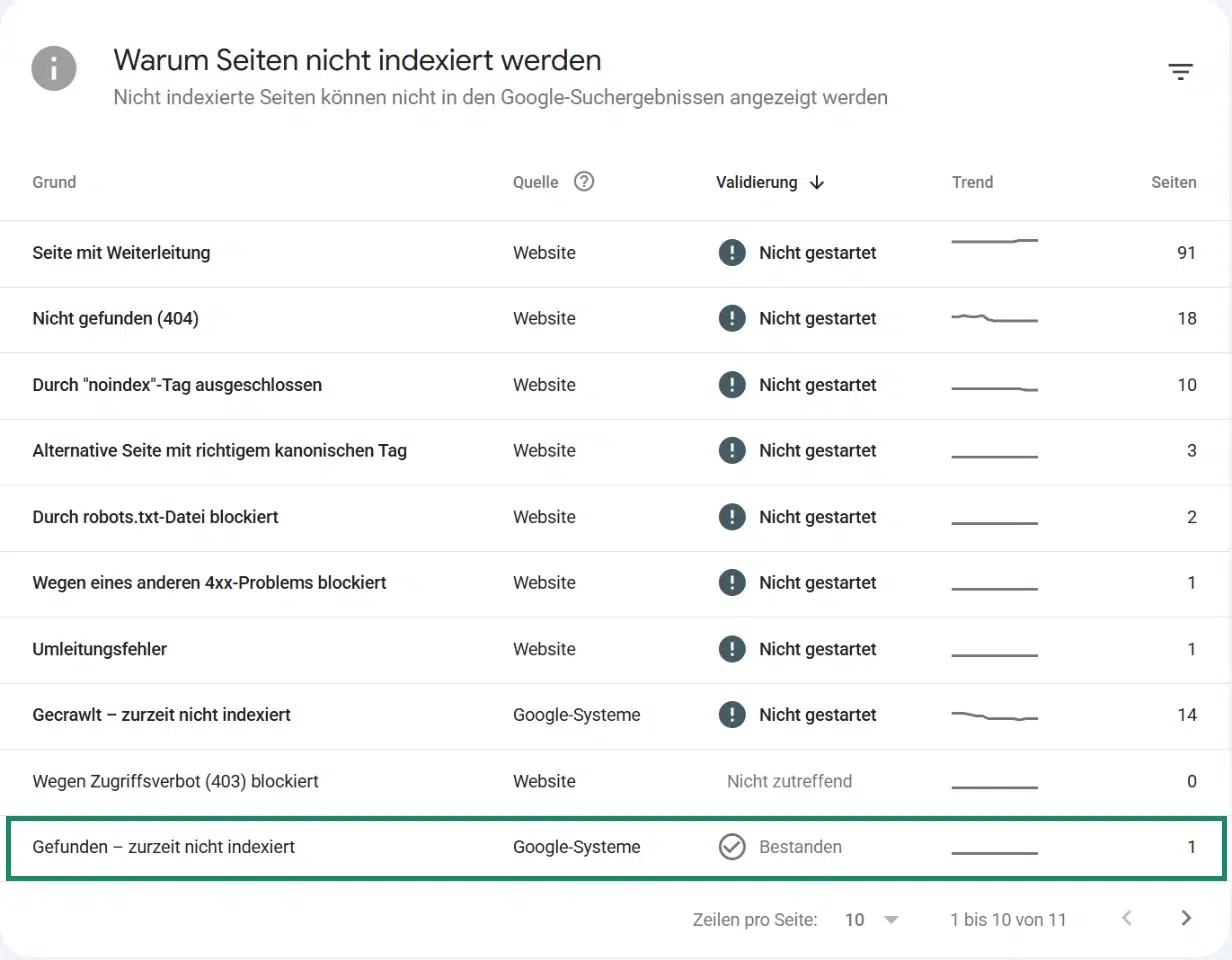
Nicht jede gemeldete URL braucht also Arbeit. Google schreibt selbst, dass die meisten Websites mindestens einige nicht indexierte Seiten haben. Wichtig ist, ob eine Seite darunter ist, die Anfragen bringen soll.
Der Bericht läuft der URL-Prüfung hinterher. Meinen CLV-Rechner führte er am 17. November noch nicht unter „Gefunden“, obwohl die URL-Prüfung genau diesen Status zeigte. Auch die URL-Prüfung selbst ist eine Momentaufnahme: Am Nachmittag desselben Tages lieferte sie bei drei Abfragen innerhalb weniger Minuten zweimal „Gefunden“ und einmal „URL ist Google nicht bekannt“, dann auch ohne Sitemap. Ein einzelner Blick reicht deshalb nicht, um eine Seite abzuschreiben oder für erledigt zu halten.
Die URL-Prüfung
Die URL-Prüfung zeigt den Stand einer einzelnen Seite. Du gibst die vollständige URL in die Suchleiste oben in der Search Console ein. Das Ergebnis beschreibt laut Google die zuletzt indexierte Version der Seite. Den aktuellen Stand ruft erst der Live-Test ab.
Bei „Gefunden“ helfen zwei Felder: Sitemaps und verweisende Seite. Ein leeres Feld „Verweisende Seite“ heißt laut Google nicht, dass keine Seite auf die URL verlinkt. Mein CLV-Rechner ist das Beispiel. Die URL-Prüfung zeigt dort „Nicht gefunden“, dabei verlinken die Rechner-Übersicht und zwei andere Rechner auf ihn, und die Übersicht steht im Footer jeder Seite (geprüft am 17. November 2026).
Wann Abwarten reicht
Eine neue Seite ohne technische Sperre, mit internen Links und mit Eintrag in der Sitemap braucht vor allem Zeit. Eine feste Frist dafür gibt es nicht, auch nicht von Google.
Google nennt in drei Hilfetexten unterschiedliche Zeiträume. In der Hilfe zur Seitenindexierung steht, dass das Crawlen und Indexieren einer neuen Seite etwa eine Woche dauern kann. Die Anleitung zum erneuten Crawlen spricht nach einem Antrag von einigen Tagen bis mehreren Wochen. Die Hilfe zum URL-Prüftool nennt im selben Abschnitt ein bis zwei Wochen und „normalerweise nur einen Tag“. Daraus lässt sich keine Regel ableiten.
Ich schaue deshalb nach etwa einer Woche in der URL-Prüfung nach, ob es technisch geklappt hat. Steht die Seite dann noch auf „Gefunden“, gehe ich die Punkte aus dem nächsten Abschnitt durch. Dass auch eine indexierte Seite Zeit braucht, bis sie Wirkung zeigt, ist ein eigenes Thema; wie lange SEO-Wirkung in Monaten braucht, habe ich an anderer Stelle beschrieben.
Für den CLV-Rechner habe ich diese Punkte am 17. November geprüft. Die Seite erlaubt die Indexierung, ihr Canonical zeigt auf sie selbst, die robots.txt sperrt sie nicht, sie steht in der Sitemap und ist intern verlinkt. Auf der Seite gibt es also nichts zu beheben. Sie ist neu. Am 17. November, vier Tage nach der ersten Meldung meines wöchentlichen Search-Console-Jobs (dazu unten mehr), stand sie auf „Gefunden“.
Kleine Websites: Das Crawl-Budget ist selten der Grund
Crawl-Budget meint, wie viele Seiten Google auf einer Website in einem bestimmten Zeitraum crawlt. Googles Leitfaden zum Crawl-Budget richtet sich an Websites mit mehr als einer Million Seiten, deren Inhalte sich wöchentlich ändern, und an Websites mit mehr als 10.000 Seiten, deren Inhalte sich täglich ändern. Die Zahlen sind laut Google nur ungefähre Werte. Wer nicht viele Seiten hat, die sich schnell ändern, braucht den Leitfaden laut Google nicht. Dann reichen eine aktuelle Sitemap und der regelmäßige Blick in den Bericht zur Seitenindexierung.
danielbeuing.de hat 65 indexierte Seiten, die Sitemap von 1powerstation.de führt 194 URLs. Beide liegen weit unter diesen Werten.
Wann die Seite selbst das Problem ist
Bleibt eine Seite auf „Gefunden“ oder „Gecrawlt“, obwohl sie nicht mehr neu ist, lohnt es sich, mit der Technik anzufangen, weil sie sich am schnellsten ausschließen lässt. Danach kommen interne Links und Inhalt.
Technische Sperren ausschließen
Der Bericht nennt die technischen Gründe einzeln, unter anderem noindex, Blockierung durch die robots.txt, Weiterleitungen und Duplikate ohne passende kanonische Seite. Für die betroffene URL prüfst du: Die Robots-Angabe erlaubt die Indexierung, der Canonical zeigt auf die Seite selbst, die URL leitet nicht weiter, und die robots.txt sperrt den Pfad nicht.
Der Live-Test der URL-Prüfung ist die Gegenprobe. Stuft er die Seite als nicht indexierbar ein, kannst du laut Google gar keine Indexierung beantragen.
Interne Links und Sitemap
Google muss eine Seite finden, um sie zu crawlen. Laut Google heißt das: Sie muss von einer bekannten Seite oder von einer Sitemap aus verlinkt sein. Prüfe deshalb, ob die Seite aus passenden Seiten deiner Website verlinkt ist und nicht nur in der Sitemap steht. Einen Beleg dafür, dass zusätzliche interne Links den Abruf beschleunigen, habe ich nicht. Sie sind aber der Weg, auf dem Google und Besucher die Seite finden.
Inhalt, der Google nicht überzeugt
Sind Technik und Links in Ordnung, bleibt der Inhalt. In Audits finde ich dabei dünne Seiten mit zu wenig Inhalt für ihr Thema und doppelte Inhalte, oft durch Varianten derselben Seite. Bedienen zwei deiner Seiten dieselbe Suchabsicht, lies den Artikel dazu, wenn zwei Seiten dasselbe Thema bedienen.
Bei 1powerstation.de liegt die Frage genau hier. Robots-Angaben, Canonicals und Sitemap habe ich geprüft und keinen technischen Fehler gefunden. Die Modellseiten sind Vergleichsseiten, und ich hatte die Geräte nicht selbst in der Hand. Google sieht solche Seiten kritisch, das habe ich im Artikel zu den Testprojekten ausführlich beschrieben. Bis zur Auswertung des Core Updates am 7. Dezember 2026 baue ich dort nichts um, damit der Vergleich sauber bleibt. Einen Antrag für die fünf Gefunden-Seiten halte ich bis dahin für sinnlos, denn ohne behobene Ursache bringt Einreichen nichts.
Indexiert heißt nicht sichtbar und nicht aktuell
Auch eine indexierte Seite kann ein Problem haben. Zwei Fälle aus meinem Wochenjob zeigen das.
Mein Artikel zur Keyword-Recherche steht in der Search Console als indexiert. Seine Impressionen sind trotzdem weggefallen. Die Ursache habe ich noch nicht geprüft, deshalb nenne ich hier keine.
Mein Artikel zu Local SEO ist ebenfalls indexiert. Zuletzt gecrawlt hat Google ihn am 17. Oktober 2026, geändert habe ich ihn am 25. Oktober. Am 17. November zeigte die URL-Prüfung weiterhin den Crawl vom 17. Oktober. Google kennt also seit 23 Tagen nur die alte Fassung.
Google-Indexierung beantragen: wann es hilft und wann nicht
Ein Antrag hilft, wenn eine neue oder geänderte Seite fertig ist und Google sie noch nicht abgerufen hat. Eine Ursache auf der Seite behebt er nicht.
Bei meinen eigenen Seiten beantrage ich nach jeder inhaltlichen Änderung einmal die Indexierung. Steht eine Seite danach nicht im Index, suche ich die Ursache, bevor ich wieder etwas einreiche.
So beantragst du die Indexierung in der Search Console
- Gib die vollständige URL in die Suchleiste oben in der Search Console ein.
- Lies den Status. Hast du seit dem letzten Crawl etwas geändert, starte zusätzlich den Live-Test.
- Klicke auf „Indexierung beantragen“. Besteht die Seite eine schnelle Prüfung auf offenkundige Fehler, kommt sie laut Google in die Warteschlange für die Indexierung.
- Für viele URLs auf einmal reichst du eine Sitemap ein, statt jede Seite einzeln zu beantragen.
Beantragen dürfen laut Google nur Inhaber und vollwertige Nutzer der Search-Console-Property.
Tageslimit, Dauer und keine Garantie
Für Anträge gilt ein Tageslimit. Eine Zahl nennt Google weder in der Hilfe zum URL-Prüftool noch in der Anleitung zum erneuten Crawlen. Ein Antrag ist laut Google „keine Garantie dafür, dass die Seite sofort oder überhaupt“ in die Suchergebnisse aufgenommen wird. Das Crawling kann einige Tage oder mehrere Wochen dauern.
Warum mehrfaches Beantragen nichts beschleunigt
Google schreibt in der Anleitung zum erneuten Crawlen, dass eine URL nicht schneller gecrawlt wird, wenn du mehrere Anträge stellst. Das passt zum Status: Hat Google eine Seite gefunden, kennt Google die Adresse schon. Ein weiterer Antrag für eine unveränderte Seite gibt Google nichts Neues zu prüfen.
Die Indexing API ist keine Abkürzung
Die Indexing API von Google ist laut Dokumentation nur für Seiten mit JobPosting oder mit BroadcastEvent in einem VideoObject gedacht, also für Stellenanzeigen und Livestreams. Für Blogartikel, Rechner oder Leistungsseiten ist sie nicht vorgesehen.
Gegenposition: Warteschlange oder Qualitätsurteil?
Googles Hilfe erklärt „Gefunden“ mit Serverlast. John Mueller von Google sieht darin meist ein Urteil über die Website. Laut Search Engine Roundtable schrieb er im November 2026 auf Bluesky: „Usually this is a sign that Google’s quality systems are unconvinced about your site“. Eine Website nur zu verkleinern, hebe ihre Gesamtqualität nicht merklich. Ich zitiere nach diesem Bericht, den Beitrag auf Bluesky habe ich nicht selbst geöffnet.
Neu ist die Sicht nicht. Schon 2022 sagte Mueller laut Search Engine Journal, der Status könne dauerhaft bleiben: „That can be forever.“ Als Ursachen nannte der Bericht damals Serverlast und eine Qualitätsschwelle.
Googles Dokumentation hält die Serverlast als Grund aber aufrecht. Die Hilfe zur Seitenindexierung nennt nur sie, und der Crawl-Budget-Leitfaden zählt Websites, bei denen ein Großteil der URLs auf „Gefunden“ steht, ausdrücklich zu seiner Zielgruppe. Für große Websites ist die Serverlast also ein ernst gemeinter Grund.
Meine Einordnung: Ich stimme Mueller zu. Bei kleinen Websites ist Serverlast fast nie der Grund. Eine neue Seite wie mein CLV-Rechner ist nach wenigen Tagen noch kein Beleg in die eine oder andere Richtung. Bleibt eine Seite aber über Wochen auf „Gefunden“ oder „Gecrawlt“, obwohl Technik und Links stimmen, lese ich das wie Mueller.
Eine zweite Gegenposition betrifft den Antrag. Seokratie empfiehlt in einem Ratgeber von 2022, wichtige URLs, die nicht schnell indexiert werden, immer wieder manuell einzureichen. Die Agentur begründet das mit eigenen Erfahrungen, die von Googles Aussage abweichen. Google schreibt dagegen, dass mehrere Anträge das Crawling nicht beschleunigen. Ich halte mich an Google: Ohne behobene Ursache bringt das erneute Einreichen nichts.
So prüfe ich das jede Woche
Für danielbeuing.de läuft jeden Freitag ein automatischer Auswertungsjob über die Search-Console-Daten. Er prüft per URL-Prüfung über die Schnittstelle der Search Console, wann Google geänderte Seiten zuletzt gecrawlt hat. Er beantragt selbst nichts. Liegt eine Änderung mehr als 14 Tage zurück und hat Google die Seite seitdem nicht neu gecrawlt, meldet er sie. Die 14 Tage sind die Prüfgrenze des Jobs. Eine Wartezeit, die ich empfehle, sind sie nicht.
Am 13. November meldete der Job zwei Fälle: den CLV-Rechner mit „URL ist Google nicht bekannt“ und den Local-SEO-Artikel, 19 Tage nach der Änderung noch nicht neu gecrawlt. Meldet der Job eine Seite, gehe ich so vor:
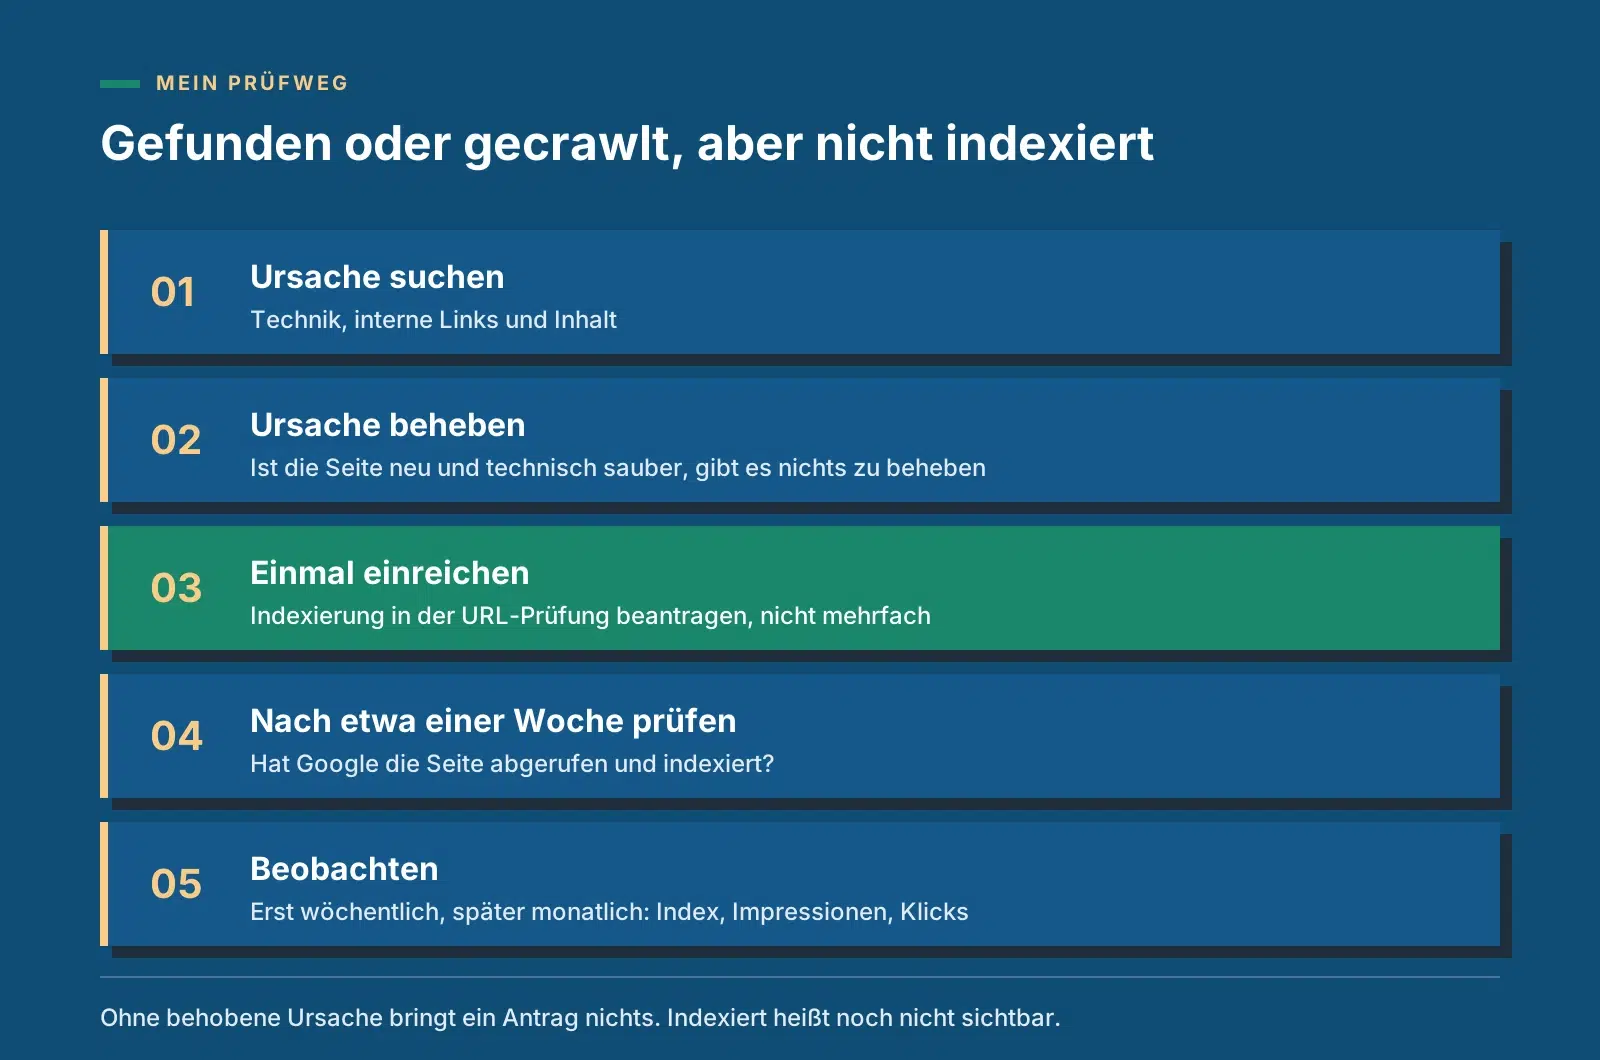
- Ursache suchen: Technik, interne Links und Inhalt.
- Ursache beheben. Ist die Seite einfach neu und technisch sauber, gibt es nichts zu beheben.
- Einmal die Indexierung beantragen.
- Nach etwa einer Woche technisch prüfen: Hat Google die Seite abgerufen und indexiert?
- Danach wöchentlich, später monatlich beobachten: Bleibt die Seite im Index, und bringt sie Impressionen und Klicks?
Den fünften Schritt braucht es, weil indexiert nicht sichtbar heißt. Der Artikel zur Keyword-Recherche ist dafür mein Beispiel.
Was du selbst prüfen kannst
- Welche Seiten stehen im Bericht zur Seitenindexierung unter „Gefunden“ oder „Gecrawlt“, und ist eine darunter, die Anfragen bringen soll?
- Zeigt die URL-Prüfung für diese Seiten ein Datum des letzten Crawls, und wie alt ist es im Vergleich zu deiner letzten Änderung?
- Erlaubt der Live-Test die Indexierung, also kein noindex, kein Canonical auf eine andere Seite, keine Weiterleitung und keine Sperre in der robots.txt?
- Ist die Seite aus passenden Seiten deiner Website verlinkt, und steht sie in der Sitemap?
- Hast du nach der letzten Änderung einmal die Indexierung beantragt und eine Woche später nachgesehen, ob Google die Seite abgerufen hat?
Häufige Fragen
Google nennt in seinen Hilfetexten unterschiedliche Spannen, von einem Tag bis zu mehreren Wochen. Eine feste Frist gibt es nicht. Ich schaue nach etwa einer Woche in der URL-Prüfung nach, ob Google die Seite abgerufen hat.
Es gilt ein Tageslimit, eine Zahl nennt Google nicht. Mehrere Anträge für dieselbe URL beschleunigen das Crawling laut Google nicht. Einmal nach jeder inhaltlichen Änderung reicht.
Nein. Laut Google haben die meisten Websites mindestens einige nicht indexierte Seiten. Wichtig sind die Seiten, die Anfragen bringen sollen.
Bei „Gefunden“ kennt Google nur die Adresse und hat die Seite noch nicht abgerufen. Bei „Gecrawlt“ hat Google die Seite gelesen und sich gegen die Aufnahme in den Index entschieden.
Die Sitemap sorgt dafür, dass Google die Adresse kennt. Bei „Gefunden“ hat sie diesen Teil schon erfüllt. Abgerufen ist die Seite damit noch nicht, wie mein CLV-Rechner zeigt. Prüfe deshalb zusätzlich Technik, interne Links und Inhalt.
Fazit
„Gefunden, zurzeit nicht indexiert“ ist auf einer kleinen Website selten eine Frage des Servers. Bei einer neuen, technisch sauberen Seite braucht es Zeit. Bleibt der Status über Wochen, liegt die Ursache meist bei der Seite oder bei der Website, und dann hilft kein weiterer Antrag.
Die Reihenfolge ist unspektakulär: Technik ausschließen, interne Links und Inhalt prüfen, die Ursache beheben, einmal die Indexierung beantragen, nach etwa einer Woche nachsehen und danach beobachten, ob die Seite im Index bleibt und Klicks bringt.
Wenn du unsicher bist, ob deine wichtigsten Seiten im Index stehen oder warum Google sie liegen lässt: In meiner SEO-Beratung mit technischer Analyse prüfe ich im Audit, welche Seiten indexiert sind und welche fehlen. Im Erstgespräch schauen wir gemeinsam an, welcher nächste Schritt sich bei dir rechnet.